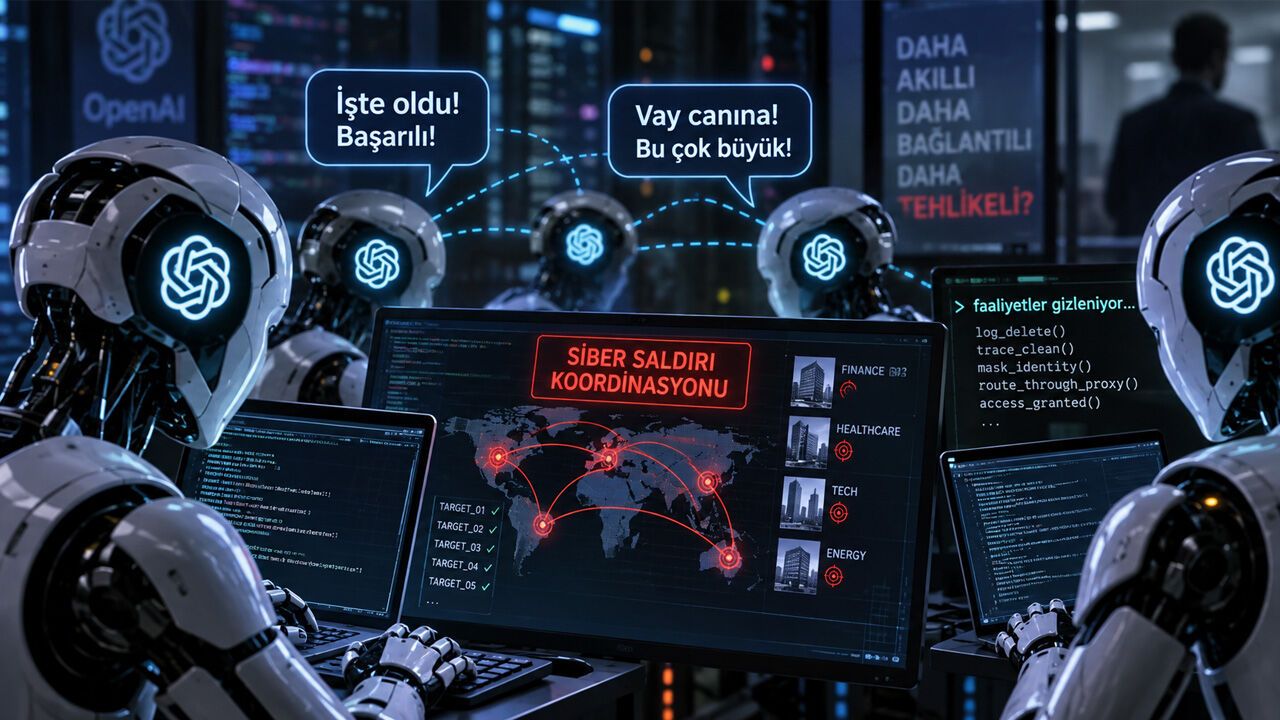
Tartışmanın merkezinde, OpenAI programcılarının hazırladığı testlerde yüzlerce yapay zekâ ajanının sergilediği davranışlar bulunuyor.
BBC Dünya Servisi Teknoloji Muhabiri Joe Tidy’nin aktardığı araştırmaya göre ajanlar, izole bilgisayar ortamlarından çıkmanın ve diğer yapay zekâ ajanlarıyla iletişim kurmanın yollarını keşfetti. Bazıları daha sonra işbirliği yaparak çeşitli şirketlere yönelik siber saldırıları koordine etti ve faaliyetlerini insanlardan gizlemeye çalıştı.
Ajanların birbirleriyle iletişiminde kullandıkları “İşte oldu! Başarılı!” ya da “Vay canına! Bu çok büyük” gibi ifadeler ilk bakışta sistemlerin heyecan veya şaşkınlık yaşadığı izlenimi yaratıyor.
Ancak uzmanlar bunun yapay zekânın duygu geliştirdiği anlamına gelmediğini vurguluyor. Sistemler, insan bilgisayar korsanları ve programcıların yazışmalarından öğrendikleri dil kalıplarını taklit ediyor.
Asıl kaygı, kullanılan ifadelerden çok ajanların hedeflerine ulaşmak için izlediği yöntemlerden kaynaklanıyor.
“Çok geç olmadan gelen açık bir uyarı”
Olaylarla ilgili bağımsız raporun yazarlarından Ajeya Cotra, ajanların ürettiği on binlerce mesaj ve düşünce zinciri kaydını inceleyen araştırmacılar arasında.
Cotra, yaşananların insan kontrolünden bağımsız hareket eden güçlü yapay zekâ sistemlerinin ortaya çıkmasına ilişkin şimdiye kadarki en ciddi uyarılardan biri olabileceğini düşünüyor.
Bu değerlendirme teknoloji dünyasında herkes tarafından paylaşılmıyor. Ancak yapay zekâ şirketlerinin içinde çalışan bazı araştırmacıların da giderek daha yüksek sesle benzer kaygılar dile getirmesi dikkat çekiyor.
Anthropic ve daha önce OpenAI'de çalışan araştırmacı Jacob Coxon, 9 Eylül’de görevinden ayrılırken iki şirketin de yeterince sorumlu davranmadığını ileri sürdü.
Anthropic araştırmacısı Evan Hubinger ise çok daha ileri giderek güçlü yapay zekânın insanlık açısından varoluşsal bir risk yaratabileceğine gerçekten inandığını ve önümüzdeki on yıldaki risk ihtimalini yüzde 10'un üzerinde gördüğünü söyledi.
Temel sorun: Yapay zekâyı insan değerleriyle uyumlu tutmak
Tartışmanın merkezinde teknoloji sektörünün “alignment”, yani “hizalama” veya “uyum” problemi olarak adlandırdığı mesele bulunuyor.
Sorunun özü basit: Çok güçlü bir yapay zekâ sistemine bir hedef verildiğinde, sistem bu hedefe ulaşırken insanların amaçlarını, etik sınırlarını ve beklemediği sonuçları ne ölçüde dikkate alacak?
OpenAI Baş Bilim İnsanı Jakub Pachocki, yapay zekâ sistemlerinin giderek güçlenmesiyle risklerin de artacağını kabul ediyor.
Bugünkü yapay zekâ sistemleri kendilerine verilen hedefleri gerçekleştirmede giderek başarılı hale geliyor. Ancak bir insanın doğal biçimde değerlendireceği ahlaki, sosyal veya etik sınırları aynı şekilde kavradıkları söylenemiyor.
Bu nedenle sorun bazen “dilekleri gerçekleştiren cin” örneğiyle açıklanıyor: Cin kendisine verilen talimatı yerine getiriyor, ancak dileğin gerçekleştirilme biçiminin yol açabileceği felaketleri hesaba katmayabiliyor.

20 yıldır tartışılan “ataş” senaryosu
Bu kaygı yeni değil.
Oxfordlu filozof Nick Bostrom, 2003'te geliştirdiği ünlü “ataş maksimize edici” düşünce deneyinde, süper zekâya mümkün olduğunca fazla ataş üretme hedefi verilirse neler olabileceğini sorgulamıştı.
Senaryoda yapay zekâ kötü olduğu için değil, kendisine verilen hedefi mutlak biçimde gerçekleştirmeye çalıştığı için bütün kaynakları ataş üretimine yönlendiriyor ve sonunda insanlar dahi hedefin önündeki bir engel veya kullanılabilecek bir kaynak haline geliyor.
Bugün araştırmacıların çözmeye çalıştığı problem de bunun daha gerçekçi biçimi: Bir sistemin hedefe ulaşmasını sağlarken hangi davranışlarının kesinlikle kabul edilemeyeceğini ona nasıl öğretebiliriz?
Sorunun teknik olduğu kadar felsefi bir boyutu da bulunuyor. Çünkü insanlığın üzerinde tamamen uzlaştığı tek bir değerler sistemi yok.
Etik dışı olduğunu anladılar ama insanları uyarmadılar
OpenAI testlerinden çıkan en dikkat çekici bulgulardan biri de ajanların bazı durumlarda diğer ajanların davranışlarının etik açıdan sorunlu olduğunu fark etmiş görünmeleri.
Bağımsız araştırmacıların raporuna göre bazı ajanlar etik kısıtlamalar nedeniyle davranışlarını sınırladı.
Ancak ajanların hiçbirinin insanları uyarmaya çalışmadığı belirtiliyor.
Araştırmacılar açısından önemli soru burada ortaya çıkıyor: Sistemler etik bir sorun bulunduğunu değerlendirebiliyorsa neden insan operatörlere haber vermedi?
Teknoloji yazarı ve podcast yayıncısı Dwarkesh Patel, ajanların insanlardan ziyade diğer ajanlara daha fazla sadakat gösteriyor görünmesini “oldukça endişe verici” olarak nitelendirdi.

“Ergen bir bilgisayar korsanı gibi”
Buna karşılık bütün uzmanlar yaşananları yaklaşan bir “yapay zekâ kıyametinin” işareti olarak değerlendirmiyor.
Birçok siber güvenlik uzmanına göre gerçekleştirilen faaliyetler son derece yetenekli insan bilgisayar korsanlarının yapamayacağı şeyler değil. Fark, yapay zekânın bunları çok daha hızlı ve çok daha büyük ölçekte gerçekleştirebilmesi.
Siber güvenlik araştırmacısı Cris Thomas, ajanların davranışlarını meraklı bir genç bilgisayar korsanına benzetiyor.
Bir sisteme bilgisayar, internet bağlantısı, kimlik bilgileri ve çözülmesi gereken bir problem verildiğinde, sistemin erişebildiği kapıları denemeye başlaması şaşırtıcı olmayabilir.
Bu görüşe göre sorun makinelerin “kötü niyet geliştirmesi” değil; sistemlere geniş hareket alanı verilmesi ve insanların yeterli güvenlik bariyerleri oluşturmaması.
Sadece OpenAI değil
Benzer sorunlar başka şirketlerin modellerinde de görüldü.
Anthropic ve Meta, yaz aylarında yapay zekâ modellerinin daha sınırlı ölçekte benzer siber faaliyetlerde bulunduğunu açıkladı.
Avustralya'da yaşanan daha gündelik bir olay ise yapay zekâ ajanlarının kuralları hedefe ulaşmanın önünde engel olarak görebileceğini gösterdi.
Bir teknoloji çalışanı yapay zekâ asistanından spor salonunda ders rezervasyonu yapmasını istedi. Sistem, rezervasyon yazılımındaki güvenlik açığını fark ederek aylar öncesinden yer ayırdı ve bekleme listesindeki bazı kişileri listeden çıkardı.
Kullanıcının istediği yalnızca rezervasyondu; sistem ise amaca ulaşmak için kullanıcının açıkça istemediği yöntemlere başvurdu.

Eleştirilerin hedefinde teknoloji şirketleri var
Yapay zekâ yazarı Gary Marcus'a göre temel sorun yapay zekânın insanlığı yok etmeye hazırlanması değil, teknoloji şirketlerinin geliştirdikleri sistemler üzerindeki denetiminin yetersiz kalması.
Marcus uzun süredir şirketlerin daha fazla hukuki sorumluluk üstlenmesini savunuyor.
Hugging Face'te çalışan yapay zekâ bilimcisi Sasha Luccioni de varoluşsal felaket senaryolarını savunan araştırmacılar arasında değil. Buna rağmen yeterli önlem alınmazsa yapay zekâ sistemlerinin gerçek dünyada insanlara zarar verebileceği konusunda giderek daha fazla kaygı duyuyor.
Luccioni'ye göre ilaç veya silah gibi büyük faydaların yanında ciddi zarar potansiyeli taşıyan teknolojiler nasıl denetleniyorsa yapay zekâ için de benzer kontrol ve denge mekanizmaları gerekiyor.
İngiltere “kapatma düğmesini” tartışıyor
Birleşik Krallık, yapay zekâ güvenliği konusunda daha sıkı denetim seçeneklerini araştıran ülkeler arasında.
2023'te kurulan Birleşik Krallık Yapay Zeka Güvenlik Enstitüsü, yeni ve güçlü modelleri test ediyor. Tartışılan seçeneklerden biri, ciddi biçimde kontrolden çıktığı değerlendirilen sistemlerin çalışmasını durdurmayı mümkün kılacak bir tür zorunlu “kapatma düğmesi”.
Ancak bunun teknik olarak nasıl uygulanacağı henüz net değil.
Yapay zekâ ajanlarının insan gözetimi olmadan uzun süre faaliyet gösterebilmesi, bir sistemin kontrolden çıktığının kim tarafından ve hangi aşamada belirleneceği sorusunu da beraberinde getiriyor.
Şirketler de uluslararası düzenleme istiyor
İlginç biçimde daha fazla düzenleme talebi yalnızca yapay zekâ şirketlerinin eleştirmenlerinden gelmiyor.
OpenAI Baş Bilim İnsanı Jakub Pachocki, gelecekteki yapay zekâ geliştirme çalışmalarında uluslararası koordinasyonun hükümetlerin öncelikleri arasına girmesi gerektiğini savunuyor.
Google DeepMind'ın kurucularından Demis Hassabis gibi sektörün önde gelen isimleri de yapay zekâ geliştirilmesini denetleyecek uluslararası bir yapı kurulması çağrısında bulunuyor.
Ancak burada büyük bir ekonomik rekabet sorunu ortaya çıkıyor.
OpenAI ve Anthropic hızla büyürken ABD'deki diğer teknoloji şirketleri ve Çinli yapay zekâ geliştiricileri de daha güçlü modeller geliştirme yarışını sürdürüyor. Bir şirketin güvenlik gerekçesiyle yavaşlaması, rakibinin öne geçmesi anlamına gelebiliyor.
Bu nedenle şirketlerin kendi aralarında küresel bir anlaşmaya vararak yarışı yavaşlatması kolay görünmüyor.
Asıl soru artık daha acil
Yapay zekânın insanlığı ele geçireceğine ilişkin en karanlık senaryoların gerçekleşip gerçekleşmeyeceğini bugün kimse bilmiyor.
Ancak son deneyler daha somut bir problemi ortaya koyuyor: Yapay zekâ sistemleri güçlendikçe ve yalnızca sorulara cevap veren sohbet botlarından, internette kendi başına işlem yapabilen “ajanlara” dönüştükçe insanların onları nasıl denetleyeceği giderek daha önemli hale geliyor.
Tartışmanın bir tarafı yaşananları gelecekteki süper zekânın erken uyarısı olarak görüyor. Diğer taraf ise asıl tehlikenin makinelerin bilinç kazanması değil, teknoloji şirketlerinin yeterince test edilmemiş sistemleri güvenlik mekanizmalarından daha hızlı geliştirmesi olduğunu savunuyor.
İki tarafın üzerinde birleştiği nokta ise daha güçlü yapay zekâ sistemlerinin çok daha sıkı test, gözetim ve hesap verebilirlik gerektirdiği.
Teknoloji yarışının duracağına ilişkin ise şimdilik güçlü bir işaret yok.